 Google Cloud Platform
 Google Workspace
 Google Map API
 DigitalOcean
 LarkSuite
 Dropbox
Sự phát triển của AI đòi hỏi hạ tầng xử lý thực sự mạnh mẽ. Vừa qua, các mô hình như DeepSeek V3.2, MiniMax-M2.5 và Qwen 3.5 397B đã có mặt trên DigitalOcean Serverless Inference. Nền tảng này đạt tốc độ đầu ra số 1 theo kiểm thử của Artificial Analysis. Cụ thể, mô hình DeepSeek V3.2 đạt tốc độ 230 token/giây. Thời gian phản hồi token đầu tiên (TTFT) cũng dưới 1 giây cho 10.000 token đầu vào.
Tìm hiểu thêm: Spot GPU Reclaim: Bí Quyết Huấn Luyện AI Không Bị Gián Đoạn
Tầm Quan Trọng Của Việc Tối Ưu Tốc Độ Suy Luận AI
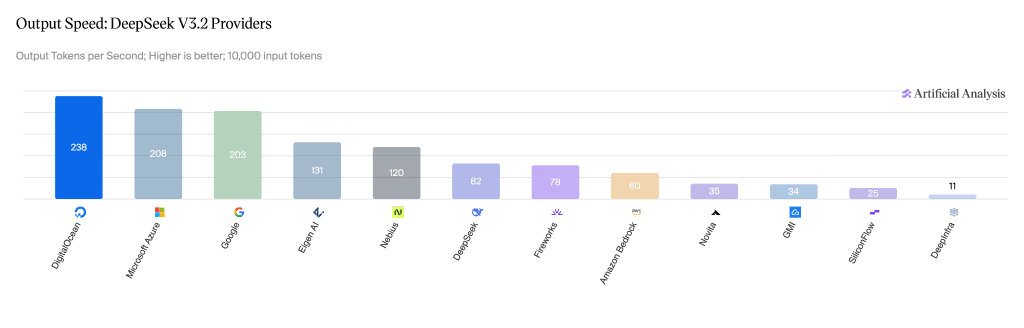
Ngành AI đang chuyển dịch từ huấn luyện mô hình sang tối ưu hóa suy luận. Tốc độ suy luận là yếu tố quyết định đối với các ứng dụng thời gian thực.
Với trợ lý ảo đàm thoại, độ trễ TTFT trên 1 giây sẽ làm giảm trải nghiệm người dùng. Ngoài ra, các quy trình AI thường gọi mô hình liên tục nhiều lần. Chậm trễ ở từng token đầu ra sẽ nhanh chóng tạo thành độ trễ lớn cho toàn hệ thống.
Sử dụng DigitalOcean Serverless Inference giúp doanh nghiệp giải quyết triệt để bài toán này. Nền tảng đảm bảo thông lượng ổn định và chi phí tối ưu cho từng token. Đây là yếu tố cốt lõi để mở rộng ứng dụng AI hiệu quả.
Kiến Trúc Phần Cứng Của DigitalOcean Serverless Inference
Để đạt được hiệu năng đứng đầu các bảng xếp hạng phân tích trí tuệ nhân tạo, hệ thống cần một sức mạnh phần cứng vượt trội. Giải pháp DigitalOcean Serverless Inference được xây dựng dựa trên GPU NVIDIA HGX B300. Đây là dòng chip sử dụng kiến trúc Blackwell Ultra tiên tiến nhất.
Dòng GPU này sở hữu bộ nhớ HBM3e lên tới 288GB, cao hơn 50% so với thế hệ B200. Sức mạnh tính toán NVFP4 cũng tăng gấp 1,5 lần. Cấu hình này giúp xử lý tốt các yêu cầu thông lượng lớn của DeepSeek và Qwen. DigitalOcean cũng hợp tác với NVIDIA để tối ưu hiệu năng trong môi trường ảo hóa.
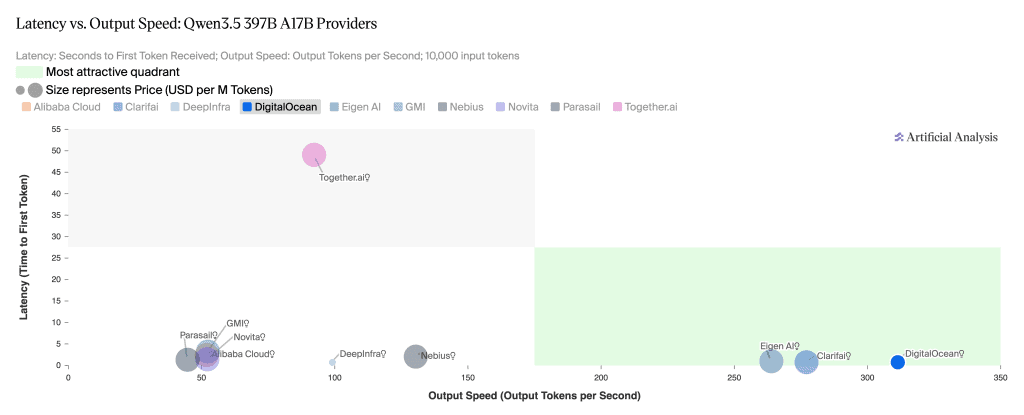
Các Tối Ưu Phần Mềm Giúp Đạt Hiệu Năng Tối Đa
Sức mạnh phần cứng cần đi kèm hệ thống phần mềm tinh gọn. Nền tảng DigitalOcean Serverless Inference áp dụng nhiều kỹ thuật tối ưu trên công cụ vLLM mã nguồn mở. Các phương pháp nổi bật bao gồm:
- Song song hóa Tensor: Phân phối các lớp mô hình lớn trên nhiều GPU qua cấu hình TP4 hoặc TP8. Kỹ thuật này rất cần thiết cho các mô hình vượt giới hạn bộ nhớ của một GPU.
- Hợp nhất Kernel: Gộp nhiều phép toán xử lý thành một GPU kernel duy nhất. Điều này giảm độ trễ truy cập bộ nhớ ngoài chip và gia tăng tốc độ xử lý.
- Khởi chạy phụ thuộc có lập trình: Kỹ thuật này cho phép các kernel hoạt động gối lên nhau. Hiệu suất cho các khối lượng công việc tương tác cao có thể cải thiện thêm 10%.
- Giải mã dự đoán và MTP: Hệ thống dùng mô hình nháp nhỏ để dự đoán trước chuỗi token. Mô hình chính sẽ xác thực trong một lần truyền duy nhất để tăng thông lượng.
- Lượng tử hóa mô hình: Hệ thống áp dụng định dạng NVFP4 4-bit chuyên dụng. Kỹ thuật này giảm 1,8 lần dung lượng bộ nhớ so với FP8 gốc nhưng vẫn giữ nguyên độ chính xác.
Ứng Dụng Thực Tế Và Hiệu Quả Vận Hành
Những công nghệ kỹ thuật lõi trên đã và đang được triển khai vào môi trường thực tế thông qua DigitalOcean Serverless Inference. Công ty Workato là một trong những khách hàng đang xử lý hàng nghìn tỷ khối lượng công việc tự động trên hệ thống này.
Kết quả cho thấy Workato đã cải thiện 77% thời gian phản hồi token đầu tiên. Độ trễ toàn hệ thống cũng giảm tới 79%. Chi phí phục vụ suy luận mô hình tiết kiệm lên đến 67%. Giải pháp phục vụ đa nút giúp công ty tăng tốc triển khai AI gấp 2-3 lần.
Kết Luận
Nền tảng DigitalOcean Serverless Inference chứng minh năng lực vượt trội nhờ kết hợp phần cứng Blackwell Ultra và tối ưu vLLM. Giải pháp này đáp ứng tốt các tiêu chuẩn độ trễ khắt khe của hệ thống AI hiện đại.
Hãy liên hệ với đội ngũ chuyên gia của chúng tôi để nhận tư vấn và hỗ trợ tích hợp hạ tầng AI hiệu năng cao ngay hôm nay.