 Google Cloud Platform
 Google Workspace
 Google Map API
 DigitalOcean
 LarkSuite
 Dropbox
DigitalOcean Inference Router Là Gì?
Việc kiểm thử và đánh giá liên tục các mô hình ngôn ngữ lớn mới ra mắt đòi hỏi đội ngũ kỹ thuật tốn rất nhiều thời gian cùng nguồn lực. Mỗi khi một mô hình mới ra mắt, doanh nghiệp thường phải mất hàng tuần thử nghiệm để quyết định xem có nên chuyển đổi hay không.
DigitalOcean Inference Router giải quyết bài toán này bằng cơ chế định tuyến tự động. Hệ thống sẽ phân tích từng yêu cầu đầu vào để lựa chọn mô hình ngôn ngữ phù hợp nhất từ thư viện có sẵn. Quá trình đánh giá dựa trên các bài kiểm tra chuẩn hóa công khai và số liệu thực tế.
Nhờ đó, doanh nghiệp loại bỏ được các bước đánh giá thủ công và không cần tự viết quy tắc định tuyến phức tạp. Bạn chỉ cần gửi câu lệnh, hệ thống sẽ tự động xử lý phần việc còn lại.
Đọc thêm: DigitalOcean Inference Router: Bí Quyết Đột Phá Tối Ưu Chi Phí AI
Cơ Chế Hoạt Động Của DigitalOcean Inference Router
Hệ thống của DigitalOcean liên tục đo lường hiệu suất của các mô hình AI trên nhiều dạng tác vụ khác nhau. Các chỉ số về độ chính xác, chi phí và độ trễ được thu thập để làm căn cứ quyết định.
Khi có yêu cầu gửi đến API, mô hình định tuyến sẽ thực hiện các bước xử lý sau:
- Phân tích nội dung và mục tiêu của câu lệnh đầu vào.
- Khớp tác vụ với danh mục xử lý tối ưu nhất.
- Cân nhắc tùy chọn ưu tiên do người dùng thiết lập như cân bằng, chất lượng hoặc ngân sách.
- Chuyển tiếp yêu cầu đến mô hình đạt điểm số cao nhất cho tác vụ đó.
Ngoài ra, DigitalOcean Inference Router còn tích hợp cơ chế nhận biết bộ nhớ đệm. Hệ thống sẽ tái sử dụng bộ nhớ đệm của mô hình hiện tại để giảm độ trễ. Việc chuyển sang mô hình khác chỉ thực hiện khi hiệu quả mang lại vượt trội hơn chi phí chuyển đổi.
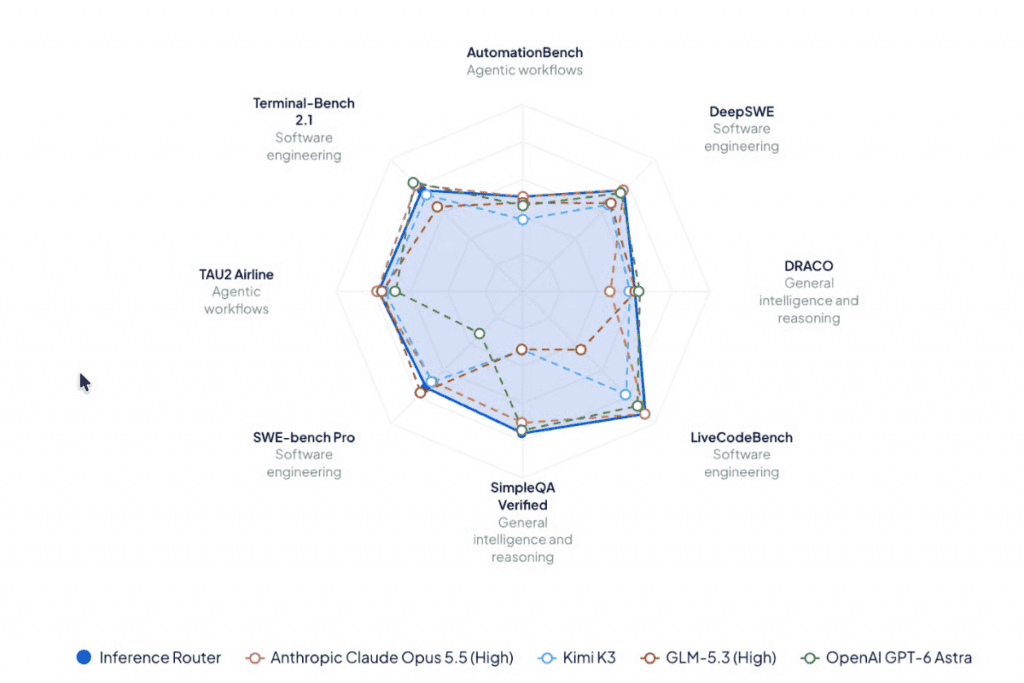
Các Danh Mục Tác Vụ Và Mô Hình Hỗ Trợ
DigitalOcean Inference Router kết nối trực tiếp với danh mục mô hình đa dạng của DigitalOcean. Danh mục này bao gồm các mô hình hàng đầu từ Anthropic, OpenAI và các mô hình mã nguồn mở như DeepSeek, Kimi hay GLM.
Hệ thống được huấn luyện ban đầu trên các nhóm tác vụ trọng tâm:
- Kỹ thuật phần mềm và phát triển ứng dụng.
- Quy trình làm việc tự động hóa dựa trên tác tử AI.
- Lý luận tổng quát và xử lý logic phức tạp.
Trong các bài kiểm tra nội bộ, việc sử dụng DigitalOcean Inference Router mang lại độ chính xác cao hơn so với việc cố định một mô hình đơn lẻ. Đồng thời, chi phí vận hành giảm khoảng 22% nhờ việc tránh sử dụng các mô hình đắt đỏ cho các tác vụ đơn giản.
Hướng Dẫn Tích Hợp DigitalOcean Inference Router
Doanh nghiệp có thể bắt đầu sử dụng công cụ này thông qua giao diện API tương thích chuẩn. Quá trình tích hợp không đòi hỏi thay đổi cấu hình hệ thống phức tạp.
Các bước triển khai cơ bản bao gồm:
- Truy cập vào trang quản trị DigitalOcean Control Panel.
- Khởi tạo khóa truy cập mô hình trong phần cài đặt.
- Cấu hình điểm kết thúc API hướng về hệ thống định tuyến của DigitalOcean.
- Khai báo tên mô hình là inference-router trong các yêu cầu gửi đi.
Người dùng có thể bổ sung tham số tùy chỉnh để định hướng hệ thống. Nếu ưu tiên tiết kiệm ngân sách, hệ thống sẽ chọn các mô hình nhỏ gọn. Nếu chọn ưu tiên chất lượng, hệ thống sẽ chọn các mô hình xử lý chuyên sâu.
Tìm hiểu thêm: How to Use Inference Router
Kết Luận
DigitalOcean Inference Router là giải pháp hiệu quả giúp tối ưu hóa cả chi phí lẫn hiệu suất khi triển khai các ứng dụng AI. Công cụ giúp doanh nghiệp tự động cập nhật những mô hình tối ưu nhất mà không tốn nguồn lực vận hành.
Nếu bạn cần tư vấn sâu hơn về kỹ thuật hoặc muốn tối ưu hóa hạ tầng Cloud/AI cho doanh nghiệp, hãy liên hệ ngay với đội ngũ chuyên gia của chúng tôi để được hỗ trợ nhanh chóng và chính xác nhất!