 Google Cloud Platform
 Google Workspace
 Google Map API
 DigitalOcean
 LarkSuite
 Dropbox
Công nghệ trí tuệ nhân tạo đang phát triển rất nhanh chóng. Nó đã trở thành cốt lõi của nhiều hệ thống doanh nghiệp. Tuy nhiên, chi phí xử lý dữ liệu đầu vào cho các mô hình AI lớn vẫn là thách thức lớn. Việc gửi lại toàn bộ ngữ cảnh hoặc lịch sử trò chuyện trong mỗi yêu cầu làm tăng chi phí. Điều này cũng làm tạo ra độ trễ cao. Để giải quyết vấn đề này, DigitalOcean đã ra mắt tính năng Prompt Caching DigitalOcean. Tính năng này hoạt động trên nền tảng Serverless Inference. Giải pháp mới giúp doanh nghiệp tối ưu chi phí vận hành và nâng cao trải nghiệm người dùng.
Đọc thêm: DigitalOcean Signals và Simulations: Giám Sát và Phát Hiện Lỗi Agent AI Thực Tế
Cơ chế hoạt động và tính năng Cache Affinity của Prompt Caching DigitalOcean
Trong các ứng dụng AI, mô hình không bắt đầu lại từ đầu ở mỗi câu hỏi. Mỗi yêu cầu mới đều kèm theo hệ thống câu lệnh và dữ liệu cũ. Theo thống kê, hơn 90% dữ liệu gửi đi là những thông tin đã từng được xử lý.
Thách thức lớn nhất của việc lưu bản tạm là đảm bảo yêu cầu quay lại đúng máy chủ ban đầu. Prompt Caching DigitalOcean giải quyết điều này bằng công nghệ định tuyến Cache Affinity:
Tự động nhận diện ngữ cảnh: Hệ thống kiểm tra dữ liệu gửi đến và khớp với bản lưu cũ. Bạn không cần tự quản lý mã định danh phiên làm việc.
Tối ưu hóa việc phân tải: Yêu cầu được điều hướng đến đúng nhóm máy chủ đã có sẵn dữ liệu tạm.
Tăng tỷ lệ phản hồi chính xác: Tỷ lệ tái sử dụng dữ liệu tạm tăng lên mức 85% đến 95% trên các mô hình lớn.
Việc lưu giữ ngữ cảnh thông minh giúp hệ thống giảm tối đa việc tính toán trùng lặp. Nhờ đó, tốc độ phản hồi đến người dùng trở nên nhanh hơn đáng kể.
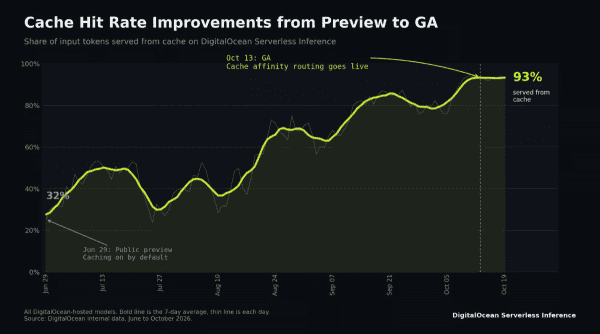
3 Lợi ích lớn nhất khi sử dụng Prompt Caching DigitalOcean
Việc tích hợp công nghệ lưu dữ liệu tạm mang lại những cải tiến rõ rệt về mặt chi phí và hiệu năng cho hệ thống AI của bạn.
Tiết kiệm chi phí đầu vào lên đến 90%
Giá cước xử lý dữ liệu được giảm tối đa 90% đối với các phần thông tin đã được lưu trong bộ nhớ tạm. Doanh nghiệp chỉ cần trả chi phí trọn gói cho những dữ liệu mới phát sinh trong câu lệnh.
Giảm độ trễ phản hồi tới 80%
Thời gian tạo ra ký tự đầu tiên giảm đáng kể do mô hình không phải đọc lại toàn bộ tài liệu từ đầu. Điều này giúp các ứng dụng trò chuyện trực tuyến phản hồi mượt mà hơn.
Hỗ trợ khung dữ liệu lớn tới 256K token
Hệ thống cho phép lưu trữ toàn bộ tập mã nguồn lớn hoặc tài liệu dài. Người dùng có thể truyền tải lượng thông tin khổng lồ trong một câu lệnh duy nhất. Bạn vẫn sẽ nhận được ưu đãi tối đa về giá.
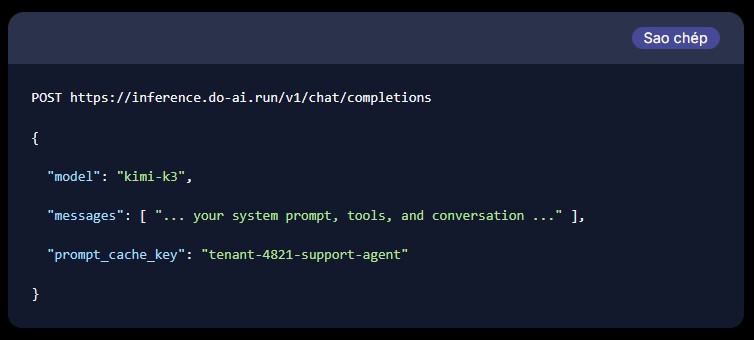
Các tính năng hỗ trợ quản lý và phân tách dữ liệu nâng cao
Bên cạnh khả năng tự động tối ưu, Prompt Caching DigitalOcean còn cung cấp nhiều công cụ quản lý hiệu quả:
Khóa phân tách dữ liệu (prompt_cache_key): Tính năng này giúp phân chia không gian lưu trữ tạm giữa các bộ phận hoặc khách hàng. Dữ liệu của từng nhóm sẽ được lưu hoàn toàn độc lập.
Bảng theo dõi hiệu quả: Giao diện quản trị hiển thị rõ ràng tỷ lệ dữ liệu được tái sử dụng. Bạn cũng xem được số tiền chính xác đã tiết kiệm.
Tích hợp linh hoạt: Hệ thống hỗ trợ cả Chat Completions API và Responses API. Bạn không cần thay đổi cấu trúc mã nguồn hiện có.
Mọi yêu cầu hợp lệ gửi đến hệ thống đều được áp dụng giảm giá tự động. Bạn có thể bắt đầu ngay bằng cách tạo khóa truy cập trên bảng điều khiển của DigitalOcean.
Tìm hiểu thêm: Prompt Caching is GA on DigitalOcean Serverless Inference: Up to 90% Off the Context Your Agents Resend
Kết luận
Công nghệ Prompt Caching DigitalOcean là bước tiến quan trọng giúp doanh nghiệp tối ưu chi phí và tăng tốc độ xử lý. Việc giảm 90% chi phí dữ liệu và 80% độ trễ sẽ giúp hệ thống vận hành hiệu quả trên quy mô lớn.
Nếu bạn cần tư vấn chi tiết hoặc hỗ trợ triển khai giải pháp hạ tầng AI, hãy liên hệ với đội ngũ chuyên gia của chúng tôi ngay hôm nay.